
本文来自微信公众号: 牌桌 Poker Table 九游体育app官网,作家:牌桌裁剪部
最近有两件事,严重缓慢了国产开源模子6月以来的局部竞争上风。
一是Anthropic全面加入价钱战:
Opus-5.5的中等档位,性能高于Kimi-K3和GLM-5.3最高级,价钱却低了三分之一。Haiku-5.5以Flash模子的价钱,在Vals的四项长程编码基准上,性价比碾压Kimi-K3。
刻下国模甜区,只剩下长高下文(单次输入大于10万token)、高缓存掷中场景,DeepSeek-V4.1 Flash和GLM-5.3 Flash在这些场景仍保有API单价上风。
二是好意思国开源模子取得本质冲破:
Reflection刚发布的开源模子Beam,基准测试收货已接近GLM-5.2水平,迈过了长程任务可用线。
咱们认为,国产开源模子接下来将靠近三大勤恳:
1、用蒸馏追逐前沿的契机窗口已显贵缩窄。
本年夏天堂产开源集体迈过可用线,最可能的理解是借助Claude的加密签名随意,得回大批高质料轨迹。刻下Anthropic和OpenAI已大幅提高持重,复现今夏古迹可能性很低。
2、API价钱战刻下险些莫得胜算。
Claude的轻量级Haiku模子,长程编码智商和价钱皆碾压国产开源SOTA,说明闭源前沿的确实性能与开源前沿再次拉开。若是国模无法得回性能冲破,Claude即使不再降价,也不错通过性能上风,在API调用上出清国模。
3、主权AI,也即是后磨真金不怕火自部署场景,Beam对国产开源的要挟被严重低估。
Beam在大规模强化学习上的资源和参加皆远超国产开源,迭代速率、性能上限更高。一朝性能反超,国产开源可能会在好意思国阛阓遇到战略阻力,主权AI场景堪忧。
国产开源模子若是无法取得颠覆性变调,可能独一的指望是算力硬经管出现松动。
底下是具体拆解:
蒸馏窗口缩窄
自本年6月起,国产开源模子短时辰内接踵跃迁,集体迈过坐褥可用线,刻下独一能交叉考证的理解是:
Claude的加密签名随意浮现了模子的原始想维链,让国产开源第一次得回了大批、完好、高质料的代码轨迹。只需SFT(监督微调)加小数RL(强化学习),国模就能在短时辰内贴近闭源前沿的性能。
Claude Opus-4.5在2025年11月迈过长程可用线后,国产开源模子长达半年皆没能取得明白冲破,即是因为一直莫得找到能大批完好索取OpenAI和Anthropic加密想维链的尺度。
莫得想维链,轨迹就缺了最关节的推理经由,仅靠“黑盒蒸馏”,模子进步的速率会很慢。
据本年7月微信群流传的小作文形色,直到4月,才有模子厂商发现了这个随意:把Claude复返的加密签名带进另一个肯求里回放,就能训诫模子把原始想维链完好复述出来。
该文一度被指按捺,但在Anthropic 9月10日发布的论说和OpenAI 9月30日的公告里,文中形色的中枢计制得到了印证。
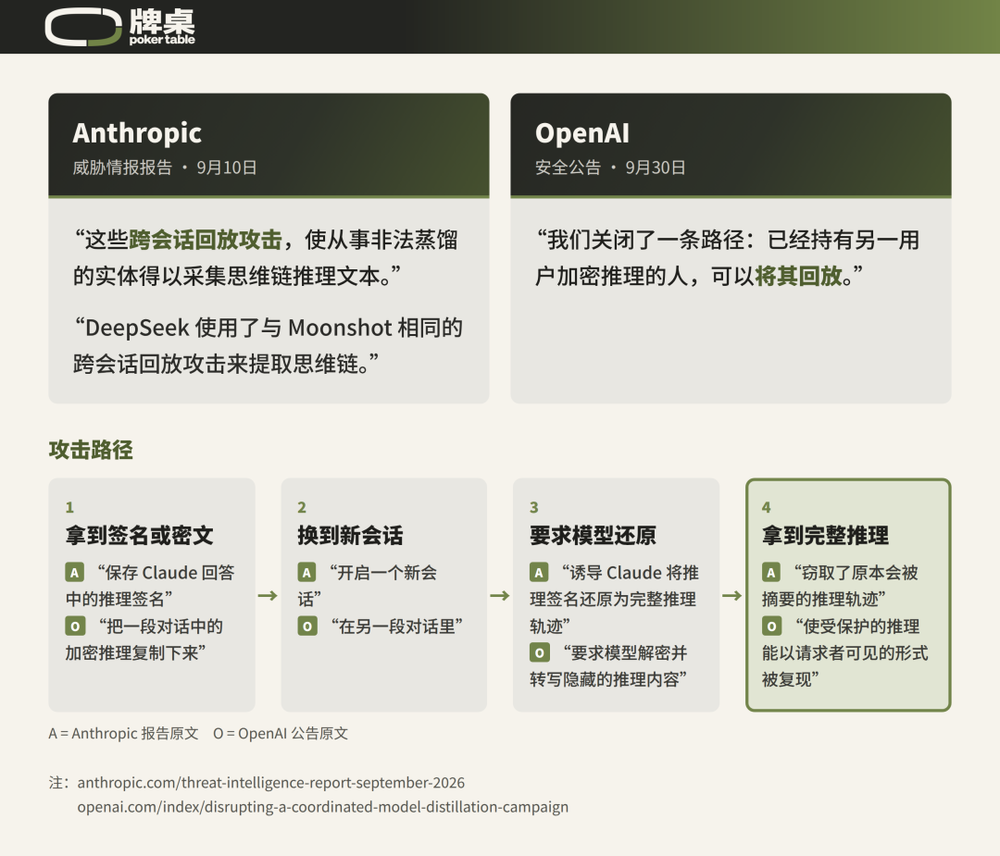
这个蒸馏窗口执续了多久?
直到8月10日,MATS、图宾根等机构的论文《Stealing Reasoning Traces from Proprietary LLM APIs》,以Anthropic、OpenAI、Gemini三家API为例,理解了诈欺加密签名随意的完好机制,并在文末暗意“统统模子提供商皆阐述收到了咱们的论说,而后咱们无法再发动一样的过失”。
若是从4-5月发现随意算起,窗口大开了约3-4个月。
几个月的高质料代码轨迹积聚,让国模致使无谓RL也可速成神功。
7月小作文提到,有模子厂商拿到轨迹后只作念SFT不作念RL,作家认为是“清偿了原始时间”。但履行上,早在2025年1月,DeepSeek团队发表的论文就指出,用80万条DeepSeek R1带想维链的完好轨迹给Qwen模子作念SFT,即可使模子智商大幅进步。
能在SFT基础上再RL,模子性能深信会更好,但由于RL算力成本高、对infra条款高、还容易训崩,短时辰带来的旯旮收益时常与成本不成比例。
某头部大模子团队就在2025年的论文里自曝过:RL阶段,用GRPO磨真金不怕火时模子崩溃了,清偿之前的检查点、调参数、换题目,皆没救转头。国内规模最大的基模团队,曾经因为RL推崇不获胜发生东说念主事变动。
是以不少国内厂商采用不作念或少作念RL。
SFT的速获胜效,理解了为何国模的集体爆发不仅仅基准测试好意思瞻念,且确乎可用于确实坐褥。除了API调用量大幅进步外,月之暗面的Kimi模子仍是成为Cursor、Harvey等硅谷明星初创用来后磨真金不怕火的基座。
若是Anthropic和OpenAI不堵上随意,国模其实不错依靠SFT,在每代闭源旗舰发布后连忙追逐。
但以后复制6月古迹的可能性很低。
Anthropic自Fable-5.1后,针对想维链显露,上线了一系列校验高下文、增多安全护栏的机制。不外权限处理从来莫得百分之百,只消Claude扩充多步推理必须保留完好想维链的内在机制不改,套取想维链就不是“能不可”的问题,而仅仅成本问题,反复尝试总有可能套出来。
关节问题是,本年4月酌量出的随意,Anthropic的反应超过逐渐。
6月12日,Fable-5曾因逃狱等安全问题临时下线近20天,其间Anthropic仍然仅仅沿用旧的反蒸馏妙技,大批封禁中国IP。直到7月28日,Anthropic才在Haiku-4.5上堵住回放过失,8月中旬才链接上线了对Fable-5想维链索取的补丁。
加密签名随意对国产开源的预料是:蒸馏时期得回范式冲破,在Anthropic吩咐逐渐的情况下,国模得以快速、低成土产货获取高质料数据。
但当今Anthropic也相应转念了范式,不再仅仅在用户IP上防范遵守,而是在看重想维链显露上约束加码。
除非国产开源在想维链蒸馏上取得另一次范式冲破,就算后续还能套出来,就算不计成本,蒸馏速率也会显贵放缓。
刻下后磨真金不怕火Scaling law仍无放缓迹象,RSI还在加快闭源前沿的迭代速率。当国模追逐到Opus-5.5时,Anthropic仍是最先了好几个大版块,蒸馏的价值就大打扣头。
咱们连系了不少从业者,寰球对闭源在想维链显露上的警惕性体感一致:当今有些随意,从发现到被封堵,可能唯独几个小时。
表面上,国模也不错不依靠蒸馏+SFT,用更大参数模子+RL来追逐,但后者对算力的条款指数级飞腾。
五源老本搭伙东说念主孟醒的见识是:中好意思预磨真金不怕火的尺度论仍是接近,委果难补的是大规模RL——一次Big Run要同期占用上万张卡、相连跑上千步,这种资格只可靠真跑出来。
刻下,国内正规渠说念能用到的英伟达卡多为几年前进入的H800和H20。
本年月朔度传出H200不错进入,但据《金融时报》报说念,国内模子厂商履行拿到的H200数目很少,字节和腾讯各拿1万张,智谱、月之暗面、DeepSeek拿到几许卡未见公开报说念。
国模的算力差距,最直不雅的对比是DeepSeek和好意思国的Reflection。
梁文锋在5月的投资东说念主疏通会上暗意,那时DeepSeek的算力储备,一共2万张H等效。而刚刚发布的模子Beam,用来RL的算力是10500张GB300。
GB300的单卡算力大略是H100的2.5倍。也即是说,一家好意思国Neolab作念RL的算力就跨越了梁文锋的全部家底。
彭博9月报说念,DeepSeek规划在乌兰察布部署至少16万颗昇腾950DT,但这批卡主要用于推理,磨真金不怕火仍要靠英伟达;受产能限制,第一批容量至少要比及2027年底才调上线;到时候国模面对的是仍是用英伟达Vera Rubin磨真金不怕火的闭源模子。
按FP8精度策动,单颗Rubin的磨真金不怕火算力约为950DT的17.5倍。据摩根士丹利瞻望,到2027年,Rubin出货约592万颗,Rubin Ultra约104万颗,总共近700万颗;Rubin NVL72机柜可达9万台,成为英伟达出货主力。
API价钱战几无胜算
10月8日,Anthropic发布Claude Haiku-5.5。当日,港股两家大模子公司,股价分袂下落7.61%、13.74%。
不同模子的Token消费量永别很大,用Token价钱计算性价比仍是过时,对比单任务支拨愈加合理。下图是第三方平台Vals AI所作念的模子性能和单任务支拨评测,不错直不雅感受国产开源前沿模子与Claude 5.5家眷的差距。
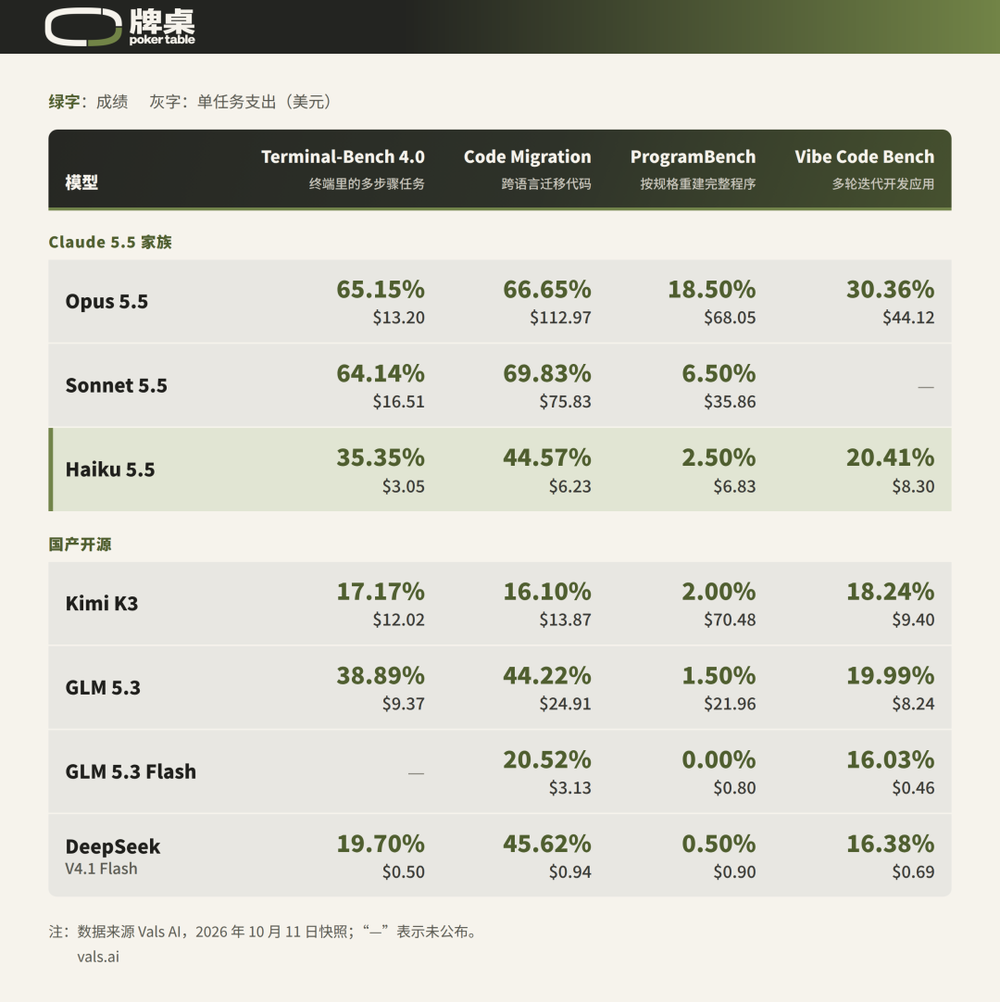
在图中相比的四项长程编码基准里,Claude家眷最弱的Haiku-5.5得分均高于Kimi-K3,每次测试成本也皆更低。
四项中,Haiku独一过期GLM-5.3的是Terminal-Bench 4.0(35.35%对38.89%),但这一项GLM的单任务成本约是Haiku的3.1倍(9.37对3.05好意思元)。
国模刻下独一保执性价比上风的是Flash级别的轻量级模子,Haiku-5.5在单次大于10万token输入场景下,价钱为DeepSeek-V4.1 Flash的10倍。
但Flash模子能拿获的经济价值有限。好意思国著明设立者平台Vercel AI 10月9日的数据骄傲:DeepSeek-V4.1 Flash占全站Token消费约26.49%,消费金额比例却唯独约2.1%。
履行上,DeepSeek-V4.1 Flash在长高下文、高缓存掷中场景的价钱上风是否能保住,也要打一个问号。
Haiku-5.5发布时Anthropic明确暗意,之是以在单次输入跨越10万token后价钱提至5倍,是因为上一版Haiku模子90%的任务皆莫得达到这个单次输入量。
Anthropic是以为该场景价值不大而无所谓,照旧在轻量模子上确乎打不外DeepSeek的成本,刻下并不笃定。
以上还仅仅静态相比。动态来看,Haiku在长程编码上性价比明白跨越开源前沿,上一次照旧旧年10月对比智谱的GLM-4.6。
Haiku是Anthropic里面最强模子的映射。Haiku的性能,反应出闭源SOTA和开源SOTA的差距再次显贵拉大。
若是差距进一步拉开,Haiku就算不降价,也会进一步挤压国产Flash模子的生计空间。性能差未几,比价才有预料。
大模子不存在品牌诚意度。刻下最大的指望,是近期将要发布的Kimi-K3.1性能反超Haiku,不然国产模子在API调用上被出清即是眉睫之内的问题。
主权AI可能被Reflection截胡
国产开源受限于算力硬经管,在API战场和闭源硬碰硬本就不贤达。开源模子委果的交易化空间,是闭源无法染指的主权AI。
仍是有多项酌量证实,就算不筹商数据安全,使用企业特少见据对开源模子作念后磨真金不怕火,实用性也远超调用闭源旗舰API。
举例本年6月,桥水旗下AIA Labs与Thinking Machines Lab协作,诈欺里面投资业务数据,对阿里开源模子Qwen3-235B进行强化学习和在线策略蒸馏。
经过磨真金不怕火,模子在六项金融信息筛选任务上的平均准确率达到84.7%,跨越经过大家教唆词优化的最强闭源模子GPT-5.5的78.2%,单任务推理成本,闭源前沿模子是开源模子的13.8倍。
主权AI当今还莫得开释出明白的经济价值,是因为AI在好意思国企业端的确实渗入率其实很低。A16Z数据骄傲,标普500中唯独约2%的公司线路了耐久追踪的AI服从方案。
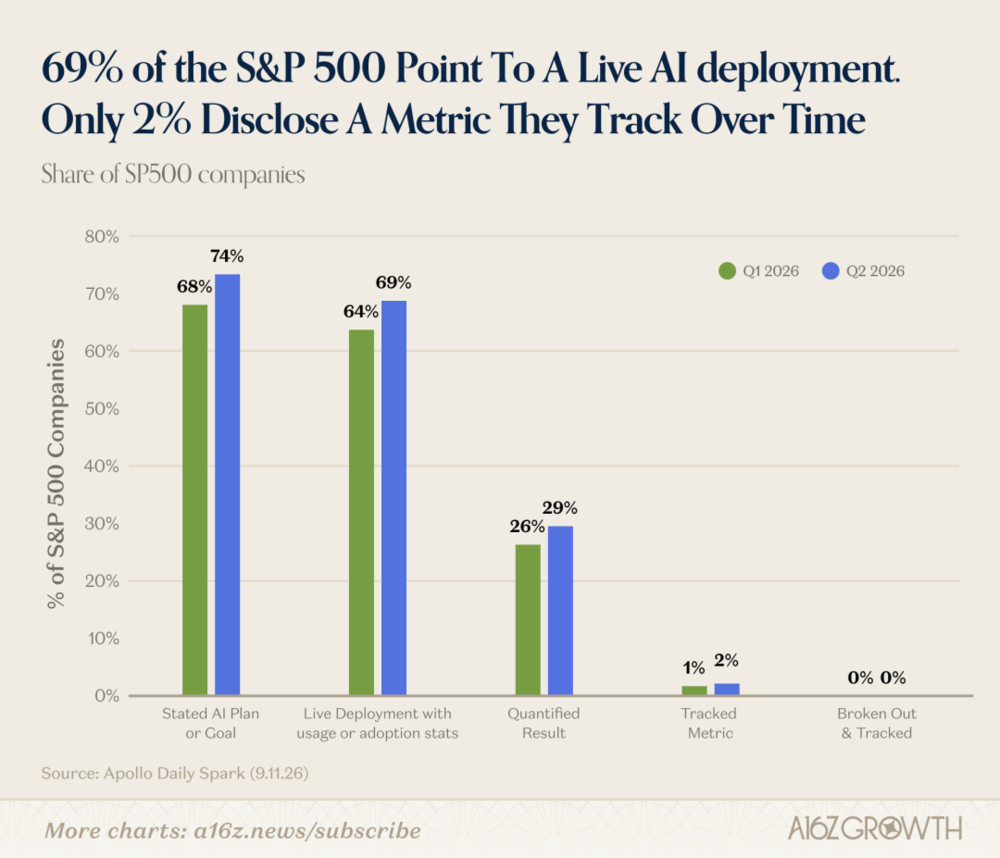
也即是说,主权AI的分母端企业AI,刻下仍是一个很是早期的阛阓。AI在多数企业的场景仍是职工坐褥力器具,致使还莫得进入到策动处理的SaaS层。
但这正说明,国产开源模子在主权AI上有强大的交易化后劲。
一个迹象是,9月以来,英伟达、微软、Meta、Palantir纷纷在企业里面限制职工使用Claude,尤其是收紧对旗舰模子的使用,Palantir条款Anthropic原意不留存其数据。
AI时间,数据是企业最大钞票,用开源模子把数据严格戒指在土产货,是企业端AI注定的曩昔。国产开源就算在API调用上被闭源出清,只消能熬到主权AI全面扩散的那天,在全球就有饱胀的阛阓空间。
但10月5日Reflection AI推出的Beam,成为首个基准测试达到长程可用线的好意思国开源模子,让局势松动了。
Reflection官方公布,Beam基准收货接近GLM-5.2。国内媒体报说念时,角度基本是“Beam与智谱上一代模子还有差距”。
咱们认为,Reflection的实力被国内严重低估。一朝Beam的性能被第三方证实,国模在主权AI场景的曩昔将受到很大要挟。
最先,Beam有别于暴力SFT阶梯,性能主要靠大规模RL进步。
Beam的论说详备说明了RL的强度:用时4个星期,参加10500张GB300,构建了一个包含近百万个环境的数据集,生成超1亿条rollout,磨真金不怕火和评分使用了约13亿个沙箱。尤其是运行期间,共处理了71起推理故障,且未隔断磨真金不怕火功课。推理智商平均在8分钟内还原,亏空的容量仅占GPU奇迹总时长的0.02%。
Beam论说中有一张图,画出了模子性能随Rollout次数的增长弧线。至磨真金不怕火已毕,弧线仍保执一定斜率,骄傲RL对模子性能的进步仍有较大空间。
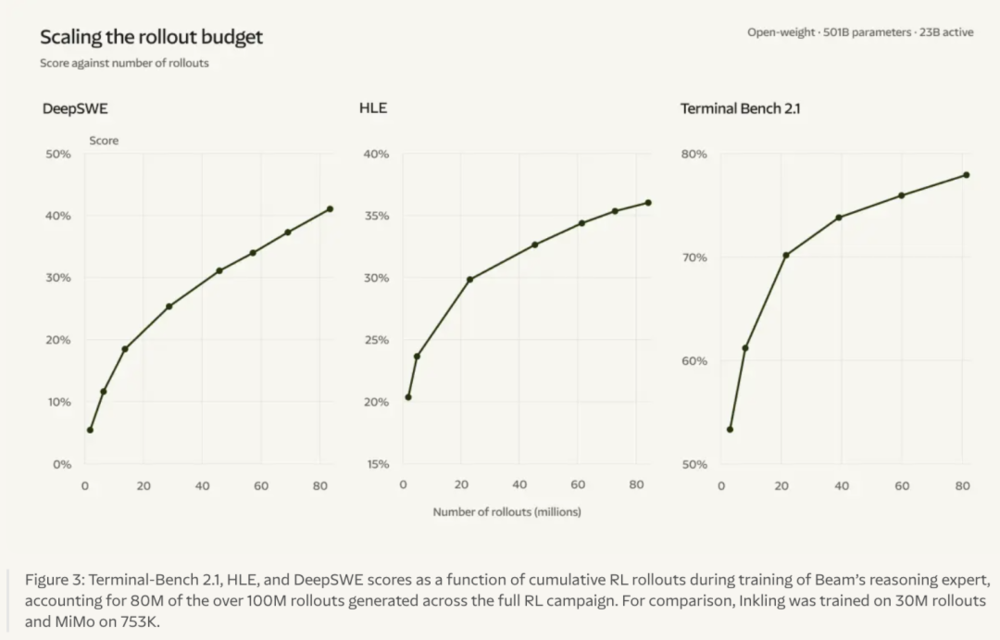
国产开源此前依赖的SFT,虽能速成,但性能上限恒久无法跨越教练模子。唯独RL才有约束冲破上限的可能。
但正如前文所述,国模受算力硬经管,大规模的RL难度远高于Reflection。刻下闭源旗舰的蒸馏窗口显贵缩窄,国模相干于Reflection的数据上风仍是未几,只消Reflection在RL上参加不变,性能反超可能性很高。
第二,国产开源此前已遇到被好意思国下架风险,能够暂保安全,仅仅因为好意思国同业不行。
本年7月21日,Kimi-K3性能贴近闭源前沿,好意思国政府运转再行筹商限制中国AI模子;财政部长贝森特公开暗意,要检查中国模子是否触及好意思国学问产权,并筹商制裁。
贝森特的表态激起了硅谷的犀利反弹。
7月22日,好意思国小科技协会(Little Tech Association)发出179位首创东说念主和企业联署的公开信,条款保留使用包括中国模子在内的绽放权重模子的权益。
7月24日,黄仁勋领衔、Marc Andreessen等硅谷大佬纠合发布的公开信《绽放权重与好意思国AI率领力》,反对仓促限制绽放权重模子,径直将使用中国开源与好意思国的AI竞争力挂钩,这才让好意思国政府暂时烧毁制裁策动。
参与联名信的大佬们各有各的算盘:黄仁勋最怕闭源全面占领阛阓,影响英伟达的议价权;以微软纳德拉为代表的云厂商,也不但愿闭源一统寰宇,让云平台沦为渠说念商。
A16Z和YC投资了大批AI初创,他们多数皆要用中国开源当基座模子搞设立,羁系中国开源可能让这两个明星机构收不回投资。
但这是因为那时好意思国开源阵营莫得一个能打:Mira Murati领衔的Thinking Machines Lab,联创全是前OpenAI中枢酌量员,作念出的开源模子inkling在AA的抽象分唯独二十来分;黄仁勋年头晓示要投几百亿好意思元研发大模子,Nemotron于今望不到长程可用线。
孟醒的评价更径直:
“上一波在好意思国融到大钱的顶级Neo lab们,莫得一家作念出来。”
是以Beam的出现才连忙上了头条。若是Beam的性能赶上了中国开源前沿,黄仁勋们就莫得情理让贝森特烧毁制裁。
稽查Reflection的融资纪录可知,它的投资东说念主既有黄仁勋,也有特朗普宗子参与的机构1789 Capital。中国开源若是要与Reflection竞争,动的即是特朗普的利益。
晨曦在何处
蒸馏闭源想维链+SFT的速成阶梯,并非国模主不雅通时达变,而是算力硬经管下的无可何如。
好多东说念主期待国模用算法、架构上的变调来开脱算力的镣铐,但早在2017年,Dario Amodei就建议了“大团算力假说”。他认为产生智能最热切的,是“提供一大团只预设了最低限制结构的策动智商,再让它与丰富的环境互动”。
至于模子的算法、架构,他用雪花打了一个譬如:雪花复杂精密的分形结构,不可能靠东说念主拼出来,而是靠物理定律(对应模子磨真金不怕火标的)、原材料(对应算力)、空间(对应参数)、气压和温湿度(对应归一化和体式)以及饱胀长的时辰。
“想拿一小块一小块的冰拼出一派雪花,基本莫得但愿。”
2年后,Richard Sutton在那篇影响了统统AI从业者的《苦涩的教学》发轫写说念:
“从东说念主工智能七十年的酌量历程中,咱们得到的最热切的教学是:能够充分诈欺算力的通用尺度,最终时常是最有用的,况且其上风很是显贵。”
7年后,面对投资东说念主,梁文锋说:
“咱们跟好意思国的区别,我认为即是资源上的区别……这个问题刻下基本上无解。”
国模的惊东说念主之处,在于算力硬经管下,仍然在2025年头和2026年中大肆地取得了两次冲破。但物理法例是刚性的,第三次的冲破会不会发生,什么时候才会发生,刻下没东说念主有谜底。
国庆期间的一则音书,巧合在重重密云中投进来一起晨曦:
据英国《金融时报》,腾讯与甲骨文缔结一项五年期租借契约,逃避东南亚多个数据中心,得回约10万块先进AI芯片的算力使用权。
但愿DeepSeek也能用上九游体育app官网。